1. 조금 난해한 이야기: 텐서
이 편은 쉬운 입구를 만들 수 없는 이야기로 시작한다. 텐서는 물리학.. 공학.. 인공지능까지 여러 영역에서 널리 쓰이는 말이지만.. 그것을 제대로 이해하고 설명할 수 있는 사람은 전 지구인 가운데 극히 일부이다. 전문 영역에서조차 디멘션의 축의 개수와 텐서의 랭크 수가 뒤섞여 쓰이고.. 딥러닝 논문과 도구 문서에서도 dimension 한 낱말이 두 수를 번갈아 가리킨다. 수학.. 물리학.. 딥러닝 세 영역이 이 문제를 제각각의 입맛대로 처리하고 있고.. 분과 사이의 용례 불일치와 그 오류의 정도를 한 틀에서 정돈해 줄 통합분과는 아직 없다. 그러니 첫 장이 한 번에 읽히지 않아도 괜찮다. 텐서를 다 이해하지 않아도 이 글이 닿으려는 곳에는 갈 수 있다. 이 장은 텐서가 무엇인지만 짚고.. 2장은 두 텐서가 어디서 갈라지는지를.. 3장부터는 그 갈림이 LLM과 JSON을 읽는 데 무엇을 바꾸는지로 넘어간다.
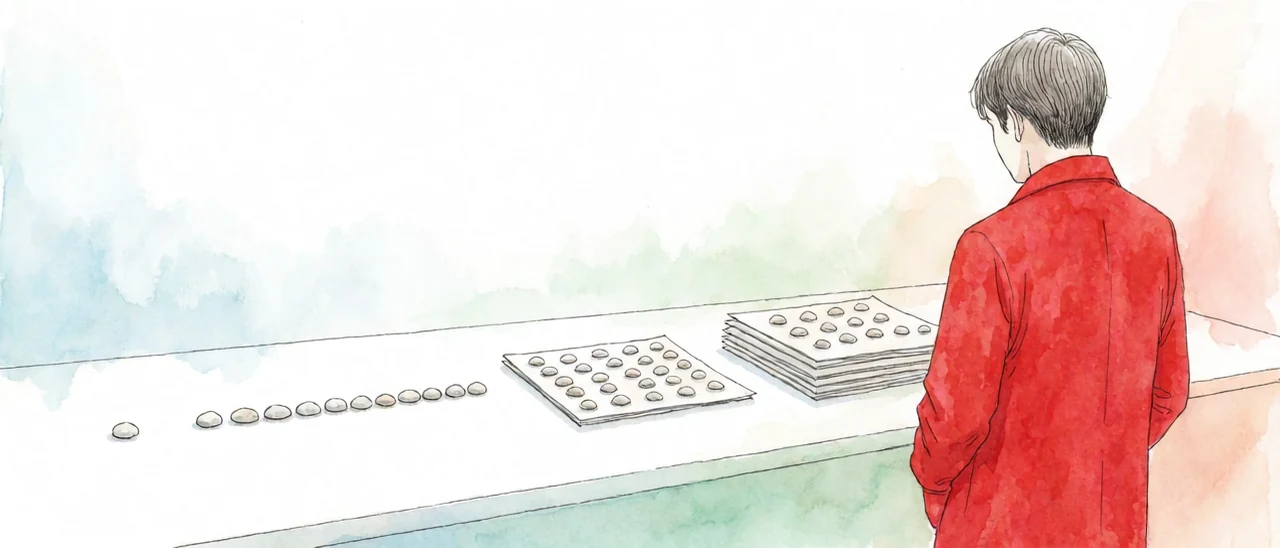
텐서는 좌표값을 몇 겹으로 늘어놓느냐로 층이 갈리고.. 이 겹의 수를 랭크라 부른다. 랭크 0인 스칼라는 축좌표계를 상정하지 않는 순수한 양 자체의 표시이다. 축을 몇 개 세우든.. 어느 쪽으로 돌리든 값이 그대로이므로 축수와 무관하다. 온도 하나.. 질량 하나가 스칼라이다. 랭크 1인 벡터는 축좌표계를 상정한 한 벌의 좌표값이다. 랭크 2인 행렬은 그 한 벌을 다시 한 줄로 늘어놓은 것이다. 늘어놓기를 한 번 더 겹칠 때마다 랭크가 하나씩 오른다. 축수는 한 벌에 담기는 좌표값의 개수를 정할 뿐.. 랭크를 바꾸지 않는다. 3축좌표계의 벡터든 768축좌표계의 벡터든 랭크는 1이다. 스칼라는 랭크 0 텐서에.. 벡터는 랭크 1 텐서에.. 행렬은 랭크 2 텐서에 붙은 별명이다. 텐서는 랭크가 몇이든 이 전부를 부르는 범용 명칭이다.
2. 물리적 텐서와 딥러닝 텐서의 분기
요 근래 유튜브 등에서 언급되는 텐서는 대부분 LLM의 텐서이다. 그런데 물리학 전공자도 하이젠베르크의 행렬역학 같은 양자역학을 풀려면 텐서 개념을 배워야 한다. 양자역학에서 상태를 담은 랭크 1 텐서인 벡터는 직접 관측되지 않고.. 관측할 수 있는 양은 그 벡터에 작용하는 랭크 2 텐서인 행렬로 표현되며.. 측정값은 그 행렬이 허용하는 값 가운데 하나로 나온다. 그리고 물리학이 쓰는 이 텐서의 원형은 다시 수학이 다룬다.
이 장은 그 가운데 물리학과 딥러닝의 텐서를 맞세운다. 이름이 같아 같은 것처럼 들리지만 하는 일이 다르다. 물리학의 텐서는 보는 방향을 바꿔도 같은 것을 가리키도록 짜 놓은 약속이고.. 딥러닝의 텐서는 숫자를 가로세로 여러 겹으로 쌓아 둔 표이다. 엑셀 시트 한 장이 랭크 2 텐서이면.. 그 시트를 여러 장 겹친 묶음이 랭크 3 텐서이다.
이러한 것을 흔히 3차원 텐서라는 식으로 부르기도 하지만 엄격히 말해 부적절한 표현이다. 랭크 3 텐서는 있어도 3차원 텐서는 없다. 그리고 물리학의 텐서와 딥러닝의 텐서를 가르는 것은 랭크도 축수도 아니다. 좌표를 바꿀 때 좌표값들이 정해진 규칙대로 함께 바뀌어야 한다는 약속이 있느냐이다. 물리학의 텐서는 이 약속을 지켜야 텐서로 인정되고.. 딥러닝의 텐서에는 이 약속이 없다.
흔히 쓰이는 물리적 텐서는 모든 겹이 같은 축좌표계를 쓴다. 3축 공간의 랭크 2 응력 텐서는 두 겹이 모두 같은 3축을 써서 좌표값이 3×3개이다. 축을 돌리면 좌표값은 모두 바뀌지만.. 모든 겹이 같은 규칙으로 함께 바뀌므로 가리키는 대상은 그대로 남는다. 이 약속이 변환규칙이며.. 교과서가 물리적 텐서를 좌표계 변환에 대해 특정 규칙을 따르는 다중선형량이라 정의하는 것도 이 약속 때문이다. 변환규칙이 정의의 일부이므로 물리적 텐서는 좌표계에 매이지 않는다. 응력 텐서.. 곡률 텐서 등이 그 예로.. 고정축·실체 가정·동일연산 요구가 성립하는 형식 층에서 채용된다. <인지공리04_2>에서 본 형식 층의 변환이다.
딥러닝 텐서는 숫자를 여러 겹으로 담는 그릇이다. 묶음 크기.. 토큰 수.. 특징 수처럼 겹마다 축수가 제각각인 경우가 흔하고.. 768×768처럼 축수가 같은 경우도 있다. 어느 쪽이든 좌표를 바꿀 때 함께 따라야 할 규칙을 약속하지 않는다. 흔히 다차원 배열이라 부르며.. 이름만 물리적 텐서와 같고 목적과 수학적 구조가 다르다. LLM이 사용하는 것은 딥러닝 텐서이다.
3. LLM 텐서의 지위
LLM의 텐서는 필자의 축좌표계에서 보면.. 토큰들 사이의 관계 성분들 — 위치정보.. 배치정보.. 층정보 등 — 을 담아내기 위한 변형·간소화 버전처럼 이해될 수도 있다.
축좌표계의 네 요소 중 셋은 LLM 텐서에도 고스란히 남아 있다. 축수는 여러 개이며.. 좌표값은 실수로 측정된다. 단위 역시 배제되지 않는다. 단위는 외부에서 약속되어 부여되는 것이 아니라.. 스케일링이라는 측정 행위 자체에 내재한다. LLM 텐서에서 이루어지는 스케일링이 곧 단위를 정하는 행위이므로.. 단위는 이미 갖춰져 있다.
배제되는 것은 축명 하나뿐이다. LLM 내부에는 각 축이 무엇을 가리키는지 새겨져 있지 않으며.. 축명은 입출력과 해석 층위에 존재한다. 이 점에서 LLM 텐서는 축좌표계에서 축명만 제거한 변형·간소화 버전이며.. 변환규칙을 정의의 일부로 갖는 물리적 텐서와 구분된다.
4. JSON의 수렴
다양한 데이터 포맷들이 시도되어 왔으나.. 가장 심플한 형태로 축명과 좌표를 대응시키는 txt 양식의 전달체계인 JSON이 현재 가장 대중적인 범용 데이터 전달 양식으로 안착되었다. JSON은 데이터를 규정해 넘긴다는 목적에서 출발했고.. 규정은 축좌표계를 요구한다. JSON의 두 구조인 객체와 배열은 이름으로 지목하기와 순서로 지목하기라는 축좌표계의 두 지목 방식에 대응한다.
JSON은 축변환 공식도.. 실체 가정도.. 좌표계 독립성도 담지 않는다. 규정의 요구.. 두 지목 방식의 대응.. 축변환과 실체의 부재. 이 세 가지가 JSON을 축좌표계 프레임으로 수렴시켰다.
5. JSON의 주소
JSON이 범용 데이터 포맷이 된 것은 축좌표계와 무관한 갈래의 사건이다. 그 포맷이 갖춘 구조는 처음부터 축좌표계 프레임을 향해 있었고.. 그 프레임이 인간 인지연산의 근본 구조이므로.. JSON의 구조는 범용화와 무관하게 축좌표계 양식으로 수렴해 간다.
인지연산에서 사용되는 축좌표계에서 포커싱되는 것은 오직 대상의 좌표값이다. 축수·축명·단위는 좌표를 도출하는 전제로 세팅되는 것이다. JSON은 데이터 형태로 기록·보존·참조하기 위해.. 이 중에서도 축명을 기준으로 좌표값을 쌍으로 엮어 전달하는 그릇.. 탈것의 모습으로 수렴되어 가고 있고.. 이것이 축좌표계 프레임에서 파악하는 JSON의 주소가 된다.